Puro-2B:普通实验室也能做预训练?
在RTX 5090上用5090美元平替Qwen2-1.5B!
普通实验室想从小模型实验走向十亿参数、万亿 token 的预训练,需要多少算力预算?
这类模型已被广泛使用,例如 Qwen2-1.5B、Qwen2.5-1.5B 和 Qwen3-1.7B。Qwen 系列公开了权重,但没有完整公开预训练配方。OLMo、SmolLM 等进一步公开了数据和训练细节,复现成本却依然很高:据估计,即使在十亿级参数规模,复现 OLMoE-1B/7B 和 SmolLM3-3B 也分别需要约 20 万美元和 71.9 万美元的算力成本。 1, 2
对于普通实验室,知道“怎么训”还不够,还得真正“训得起”。我们需要一套低成本、可复现的“穷人版”预训练方案。
Puro-2B:全流程开源的“穷人版”预训练方案
为此,我们推出 Puro-2B(普罗-2B),并公开了训练数据、训练框架、训练配置和模型权重。
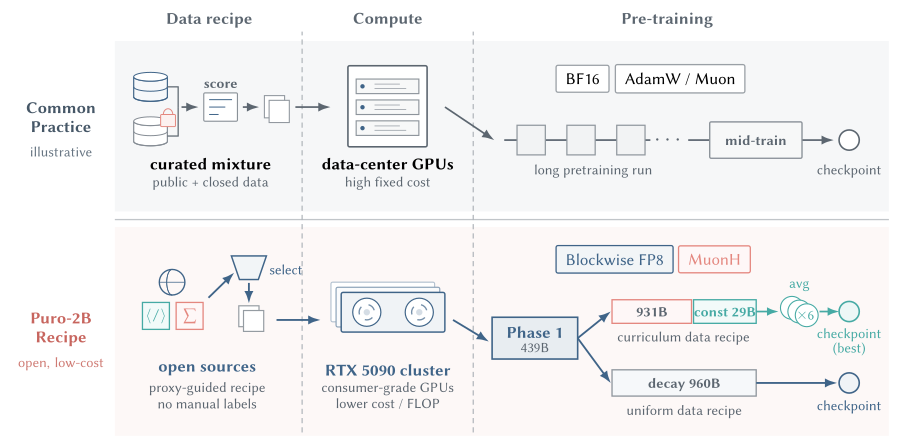
我们在消费级显卡 RTX 5090 的计算集群上,从头训练了约 20 亿参数的模型。我们尝试了不同的训练规模,最多使用了 1.4 万亿 token。依据我们的配方,用 4400 美元的预训练计算成本,便能在 15 项任务的平均性能上达到 Qwen2-1.5B 水平(还没花到 5090,标题先借显卡型号玩个梗)。采用更完整训练配方的实验,使用约 6900 美元的成本,平均性能可以接近 Qwen2.5-1.5B。相比其他开源方案,Puro-2B 显著降低了训练成本。
论文:arXiv:2608.27370
开源仓库:Puro-Megatron
模型与数据合集:Puro-2B on Hugging Face
左右滑动查看全部 15 个模型
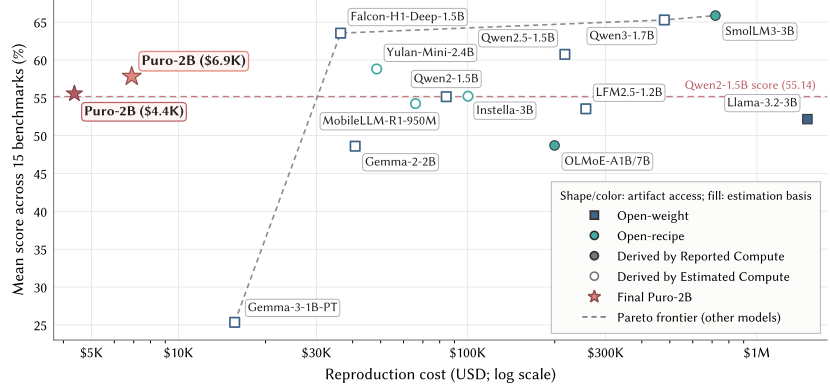
完整成本对照(Table 7)
| 模型名称 | 开放类型 | 估算 / 测量方法 | 价格基准 | GPU 卡时 | CNY | USD | AVG (%) |
|---|---|---|---|---|---|---|---|
| Qwen2-1.5B | 开源权重 | 6ND,单模型 token 数 | H100 等效估算 | 25,939 | ¥573,817 | $84,302 | 55.14 |
| Qwen2.5-1.5B | 开源权重 | 6ND,模型系列 token 数 | H100 等效估算 | 66,700 | ¥1,475,530 | $216,776 | 60.73 |
| Qwen3-1.7B-Base | 开源权重 | 6ND,单模型 token 数 | H100 等效估算 | 147,261 | ¥3,257,664 | $478,597 | 65.27 |
| Gemma-2-2B | 开源权重 | 6ND,单模型 token 数 | H100 等效估算 | 12,560 | ¥277,860 | $40,821 | 48.60 |
| Gemma-3-1B-PT | 开源权重 | 6ND,单模型 token 数 | H100 等效估算 | 4,812 | ¥106,460 | $15,640 | 25.34 |
| Llama-3.2-3B | 开源权重 | 原文报告 GPU 卡时 | H100 | 460,000 | ¥10,176,017 | $1,495,000 | 52.17 |
| LFM2.5-1.2B-Base | 开源权重 | 6ND,模型系列 token 数 | H100 等效估算 | 78,828 | ¥1,743,808 | $256,190 | 53.54 |
| Falcon-H1-Deep-1.5B-Base | 开源权重 | 6ND,模型系列 token 数 | H100 等效估算 | 11,189 | ¥247,519 | $36,364 | 63.53 |
| Instella-3B | 全流程开源(模型+数据集) | 6ND,单模型 token 数 | H100 等效估算 | 30,851 | ¥682,470 | $100,265 | 55.20 |
| OLMoE-1B-7B-0125 | 全流程开源(模型+数据集) | 原文报告卡数与时间 | H100 | 61,440 | ¥1,359,162 | $199,680 | 48.70 |
| Yulan-Mini-2.4B | 全流程开源(模型+数据集) | 6ND,使用报告的 MFU | A100 80GB 等效估算 | 27,073 | ¥329,857 | $48,461 | 58.80 |
| SmolLM3-3B-Base | 全流程开源(模型+数据集) | 原文报告卡数与时间 | H100 | 221,184 | ¥4,892,983 | $718,848 | 65.85 |
| MobileLLM-R1-950M-base | 全流程开源(模型+数据集) | 原文报告卡数与时间 | A100 80GB 等效估算 | 36,864 | ¥449,151 | $65,987 | 54.23 |
| Puro-2B | Puro 训练结果 | 实测 GPU 卡时 | RTX 5090 | 22,514 | ¥46,905 | $6,891 | 57.81 |
上述统计,只计正式预训练 GPU 成本,不代表项目总成本。
查看模型详情与评分
Qwen2-1.5B55.14%
- 开放类型
- 开源权重
- 原文链接
- 技术报告 / 官方模型资料 ↗
- GPU 卡时
- 25,939
- 美元成本
- $84,302
- 人民币成本估计
- ¥573,817
- 平均性能
- 55.14%
- 估算 / 测量方法
- 使用 C = 6ND,以对应模型的训练 token 数估算。
N = 1.54B,D = 7T(模型 token)。 - 价格基准
- H100:$3.25/卡时(22.121775 元/卡时)。 等效估算:BF16 989.5 TFLOP/s,MFU = 70%。
| Benchmark | 分数(%) |
|---|---|
| GSM8K | 59.82 |
| MATH | 23.70 |
| sanitized-MBPP | 50.19 |
| HumanEval | 27.44 |
| MMLU | 56.39 |
| MMLU-Pro | 23.62 |
| ARC-Challenge | 69.83 |
| ARC-Easy | 83.77 |
| BoolQ | 71.90 |
| CommonsenseQA | 70.52 |
| HellaSwag | 59.91 |
| PIQA | 75.19 |
| SocialIQA | 63.36 |
| WinoGrande | 59.67 |
| BBH | 31.73 |
| AVG | 55.14 |
Qwen2.5-1.5B60.73%
- 开放类型
- 开源权重
- 原文链接
- 技术报告 / 官方模型资料 ↗
- GPU 卡时
- 66,700
- 美元成本
- $216,776
- 人民币成本估计
- ¥1,475,530
- 平均性能
- 60.73%
- 估算 / 测量方法
- 使用 C = 6ND,以模型系列使用的训练 token 数估算。
N = 1.54B,D = 18T(模型系列使用的训练 token 数)。 - 价格基准
- H100:$3.25/卡时(22.121775 元/卡时)。 等效估算:BF16 989.5 TFLOP/s,MFU = 70%。
| Benchmark | 分数(%) |
|---|---|
| GSM8K | 67.70 |
| MATH | 32.28 |
| sanitized-MBPP | 58.37 |
| HumanEval | 31.71 |
| MMLU | 61.56 |
| MMLU-Pro | 30.43 |
| ARC-Challenge | 79.32 |
| ARC-Easy | 90.48 |
| BoolQ | 76.39 |
| CommonsenseQA | 75.10 |
| HellaSwag | 64.18 |
| PIQA | 76.17 |
| SocialIQA | 64.94 |
| WinoGrande | 59.67 |
| BBH | 42.64 |
| AVG | 60.73 |
Qwen3-1.7B-Base65.27%
- 开放类型
- 开源权重
- 原文链接
- 技术报告 / 官方模型资料 ↗
- GPU 卡时
- 147,261
- 美元成本
- $478,597
- 人民币成本估计
- ¥3,257,664
- 平均性能
- 65.27%
- 估算 / 测量方法
- 使用 C = 6ND,以对应模型的训练 token 数估算。
N = 1.70B,D = 36T,仅计预训练。 - 价格基准
- H100:$3.25/卡时(22.121775 元/卡时)。 等效估算:BF16 989.5 TFLOP/s,MFU = 70%。
| Benchmark | 分数(%) |
|---|---|
| GSM8K | 76.04 |
| MATH | 42.44 |
| sanitized-MBPP | 64.20 |
| HumanEval | 51.22 |
| MMLU | 65.47 |
| MMLU-Pro | 37.60 |
| ARC-Challenge | 80.34 |
| ARC-Easy | 91.89 |
| BoolQ | 79.63 |
| CommonsenseQA | 74.69 |
| HellaSwag | 60.47 |
| PIQA | 76.06 |
| SocialIQA | 68.68 |
| WinoGrande | 59.19 |
| BBH | 51.18 |
| AVG | 65.27 |
Gemma-2-2B48.60%
- 开放类型
- 开源权重
- 原文链接
- 技术报告 / 官方模型资料 ↗
- GPU 卡时
- 12,560
- 美元成本
- $40,821
- 人民币成本估计
- ¥277,860
- 平均性能
- 48.60%
- 估算 / 测量方法
- 使用 C = 6ND,以对应模型的训练 token 数估算。
N = 2.61B,D = 2T。 - 价格基准
- H100:$3.25/卡时(22.121775 元/卡时)。 等效估算:BF16 989.5 TFLOP/s,MFU = 70%。
| Benchmark | 分数(%) |
|---|---|
| GSM8K | 33.81 |
| MATH | 14.84 |
| sanitized-MBPP | 38.52 |
| HumanEval | 20.12 |
| MMLU | 55.22 |
| MMLU-Pro | 24.40 |
| ARC-Challenge | 66.44 |
| ARC-Easy | 82.54 |
| BoolQ | 71.83 |
| CommonsenseQA | 66.18 |
| HellaSwag | 35.22 |
| PIQA | 66.10 |
| SocialIQA | 65.86 |
| WinoGrande | 52.01 |
| BBH | 35.88 |
| AVG | 48.60 |
Gemma-3-1B-PT25.34%
- 开放类型
- 开源权重
- 原文链接
- 技术报告 / 官方模型资料 ↗
- GPU 卡时
- 4,812
- 美元成本
- $15,640
- 人民币成本估计
- ¥106,460
- 平均性能
- 25.34%
- 估算 / 测量方法
- 使用 C = 6ND,以对应模型的训练 token 数估算。
N = 1.00B,D = 2T。 - 价格基准
- H100:$3.25/卡时(22.121775 元/卡时)。 等效估算:BF16 989.5 TFLOP/s,MFU = 70%。
| Benchmark | 分数(%) |
|---|---|
| GSM8K | 2.58 |
| MATH | 0.94 |
| sanitized-MBPP | 9.34 |
| HumanEval | 8.54 |
| MMLU | 26.17 |
| MMLU-Pro | 11.77 |
| ARC-Challenge | 26.78 |
| ARC-Easy | 26.46 |
| BoolQ | 62.91 |
| CommonsenseQA | 20.56 |
| HellaSwag | 25.65 |
| PIQA | 49.40 |
| SocialIQA | 32.55 |
| WinoGrande | 49.57 |
| BBH | 26.89 |
| AVG | 25.34 |
Llama-3.2-3B52.17%
- 开放类型
- 开源权重
- 原文链接
- 技术报告 / 官方模型资料 ↗
- GPU 卡时
- 460,000
- 美元成本
- $1,495,000
- 人民币成本估计
- ¥10,176,017
- 平均性能
- 52.17%
- 估算 / 测量方法
- 原文直接报告 GPU-hours,再按 Table 6 单价换算。
报告 460,000 H100 GPU-hours,不包含另行报告的系列共享 logit 生成开销。 - 价格基准
- H100:$3.25/卡时(22.121775 元/卡时)。
| Benchmark | 分数(%) |
|---|---|
| GSM8K | 28.20 |
| MATH | 8.14 |
| sanitized-MBPP | 50.19 |
| HumanEval | 31.10 |
| MMLU | 57.55 |
| MMLU-Pro | 27.71 |
| ARC-Challenge | 72.88 |
| ARC-Easy | 84.83 |
| BoolQ | 76.02 |
| CommonsenseQA | 66.91 |
| HellaSwag | 48.12 |
| PIQA | 76.06 |
| SocialIQA | 64.28 |
| WinoGrande | 52.57 |
| BBH | 38.01 |
| AVG | 52.17 |
LFM2.5-1.2B-Base53.54%
- 开放类型
- 开源权重
- 原文链接
- 技术报告 / 官方模型资料 ↗
- GPU 卡时
- 78,828
- 美元成本
- $256,190
- 人民币成本估计
- ¥1,743,808
- 平均性能
- 53.54%
- 估算 / 测量方法
- 使用 C = 6ND,以模型系列使用的训练 token 数估算。
N = 1.17B,D = 28T(模型系列使用的训练 token 数)。 - 价格基准
- H100:$3.25/卡时(22.121775 元/卡时)。 等效估算:BF16 989.5 TFLOP/s,MFU = 70%。
| Benchmark | 分数(%) |
|---|---|
| GSM8K | 53.22 |
| MATH | 28.00 |
| sanitized-MBPP | 38.13 |
| HumanEval | 25.61 |
| MMLU | 57.50 |
| MMLU-Pro | 17.74 |
| ARC-Challenge | 82.03 |
| ARC-Easy | 87.83 |
| BoolQ | 74.40 |
| CommonsenseQA | 59.13 |
| HellaSwag | 54.20 |
| PIQA | 74.97 |
| SocialIQA | 59.26 |
| WinoGrande | 57.54 |
| BBH | 33.54 |
| AVG | 53.54 |
Falcon-H1-Deep-1.5B-Base63.53%
- 开放类型
- 开源权重
- 原文链接
- 技术报告 / 官方模型资料 ↗
- GPU 卡时
- 11,189
- 美元成本
- $36,364
- 人民币成本估计
- ¥247,519
- 平均性能
- 63.53%
- 估算 / 测量方法
- 使用 C = 6ND,以模型系列使用的训练 token 数估算。
N = 1.55B,D = 3T(模型系列所用的 token 量)。报告披露,使用 H100 集群训练。 - 价格基准
- H100:$3.25/卡时(22.121775 元/卡时)。 等效估算:BF16 989.5 TFLOP/s,MFU = 70%。
| Benchmark | 分数(%) |
|---|---|
| GSM8K | 53.53 |
| MATH | 41.28 |
| sanitized-MBPP | 63.04 |
| HumanEval | 32.93 |
| MMLU | 68.74 |
| MMLU-Pro | 42.99 |
| ARC-Challenge | 85.08 |
| ARC-Easy | 93.12 |
| BoolQ | 85.23 |
| CommonsenseQA | 72.40 |
| HellaSwag | 65.24 |
| PIQA | 76.61 |
| SocialIQA | 70.83 |
| WinoGrande | 60.14 |
| BBH | 41.86 |
| AVG | 63.53 |
Instella-3B55.20%
- 开放类型
- 全流程开源(模型+数据集)
- 原文链接
- 技术报告 / 官方模型资料 ↗
- GPU 卡时
- 30,851
- 美元成本
- $100,265
- 人民币成本估计
- ¥682,470
- 平均性能
- 55.20%
- 估算 / 测量方法
- 使用 C = 6ND,以对应模型的训练 token 数估算。
N = 3.11B,D = 4.122575T(4.065T + 57.575B)。 - 价格基准
- H100:$3.25/卡时(22.121775 元/卡时)。 等效估算:BF16 989.5 TFLOP/s,MFU = 70%。
| Benchmark | 分数(%) |
|---|---|
| GSM8K | 64.44 |
| MATH | 13.30 |
| sanitized-MBPP | 41.25 |
| HumanEval | 14.63 |
| MMLU | 58.55 |
| MMLU-Pro | 25.32 |
| ARC-Challenge | 74.92 |
| ARC-Easy | 87.30 |
| BoolQ | 76.76 |
| CommonsenseQA | 75.43 |
| HellaSwag | 59.92 |
| PIQA | 73.23 |
| SocialIQA | 69.91 |
| WinoGrande | 53.99 |
| BBH | 39.11 |
| AVG | 55.20 |
OLMoE-1B-7B-012548.70%
- 开放类型
- 全流程开源(模型+数据集)
- 原文链接
- 技术报告 / 官方模型资料 ↗
- GPU 卡时
- 61,440
- 美元成本
- $199,680
- 人民币成本估计
- ¥1,359,162
- 平均性能
- 48.70%
- 估算 / 测量方法
- 原文报告 GPU 数量及训练时间,卡时 = 卡数 × 小时数。
256 张 H100 × 约 10 天 × 24 小时 = 61,440 GPU-hours,时间为约数。 - 价格基准
- H100:$3.25/卡时(22.121775 元/卡时)。
| Benchmark | 分数(%) |
|---|---|
| GSM8K | 54.59 |
| MATH | 15.48 |
| sanitized-MBPP | 33.46 |
| HumanEval | 12.80 |
| MMLU | 54.11 |
| MMLU-Pro | 19.67 |
| ARC-Challenge | 66.44 |
| ARC-Easy | 84.30 |
| BoolQ | 72.97 |
| CommonsenseQA | 62.82 |
| HellaSwag | 36.54 |
| PIQA | 71.16 |
| SocialIQA | 65.15 |
| WinoGrande | 50.28 |
| BBH | 30.74 |
| AVG | 48.70 |
Yulan-Mini-2.4B58.80%
- 开放类型
- 全流程开源(模型+数据集)
- 原文链接
- 技术报告 / 官方模型资料 ↗
- GPU 卡时
- 27,073
- 美元成本
- $48,461
- 人民币成本估计
- ¥329,857
- 平均性能
- 58.80%
- 估算 / 测量方法
- 使用 C = 6ND,并采用报告的 MFU 51.57% 与 A800 BF16 峰值 312 TFLOP/s。
N = 2.42B,D = 1.08T。 GPU-hours 使用报告的 MFU 换算,A800 成本按 A100 80GB 单价等效估算。 - 价格基准
- 按 A100 80GB 单价折算:$1.79/卡时(约 12.184 元/卡时)。
| Benchmark | 分数(%) |
|---|---|
| GSM8K | 68.99 |
| MATH | 27.18 |
| sanitized-MBPP | 62.26 |
| HumanEval | 50.00 |
| MMLU | 51.74 |
| MMLU-Pro | 23.68 |
| ARC-Challenge | 65.08 |
| ARC-Easy | 82.54 |
| BoolQ | 78.47 |
| CommonsenseQA | 66.18 |
| HellaSwag | 59.92 |
| PIQA | 76.22 |
| SocialIQA | 63.31 |
| WinoGrande | 62.35 |
| BBH | 44.12 |
| AVG | 58.80 |
SmolLM3-3B-Base65.85%
- 开放类型
- 全流程开源(模型+数据集)
- 原文链接
- 技术报告 / 官方模型资料 ↗
- GPU 卡时
- 221,184
- 美元成本
- $718,848
- 人民币成本估计
- ¥4,892,983
- 平均性能
- 65.85%
- 估算 / 测量方法
- 原文报告 GPU 数量及训练时间,卡时 = 卡数 × 小时数。
384 张 H100 × 24 天 × 24 小时 = 221,184 GPU-hours。 - 价格基准
- H100:$3.25/卡时(22.121775 元/卡时)。
| Benchmark | 分数(%) |
|---|---|
| GSM8K | 81.73 |
| MATH | 56.12 |
| sanitized-MBPP | 60.31 |
| HumanEval | 37.80 |
| MMLU | 62.24 |
| MMLU-Pro | 39.02 |
| ARC-Challenge | 79.32 |
| ARC-Easy | 89.95 |
| BoolQ | 84.80 |
| CommonsenseQA | 72.73 |
| HellaSwag | 70.23 |
| PIQA | 81.12 |
| SocialIQA | 70.62 |
| WinoGrande | 64.25 |
| BBH | 37.52 |
| AVG | 65.85 |
MobileLLM-R1-950M-base54.23%
- 开放类型
- 全流程开源(模型+数据集)
- 原文链接
- 技术报告 / 官方模型资料 ↗
- GPU 卡时
- 36,864
- 美元成本
- $65,987
- 人民币成本估计
- ¥449,151
- 平均性能
- 54.23%
- 估算 / 测量方法
- 原文报告 GPU 数量及训练时间,卡时 = 卡数 × 小时数。
官方训练表列出 128 张 GPU,两个 4–5 天的预训练阶段和两个 1–2 天的中期训练阶段,共 30,720–43,008 卡时,按中点 36,864 卡时计。训练表未注明 GPU 型号,成本按 A100 80GB 单价折算。 - 价格基准
- 按 A100 80GB 单价折算:$1.79/卡时(约 12.184 元/卡时)。
| Benchmark | 分数(%) |
|---|---|
| GSM8K | 68.31 |
| MATH | 27.24 |
| sanitized-MBPP | 50.58 |
| HumanEval | 43.29 |
| MMLU | 48.24 |
| MMLU-Pro | 21.95 |
| ARC-Challenge | 58.31 |
| ARC-Easy | 78.13 |
| BoolQ | 78.87 |
| CommonsenseQA | 61.59 |
| HellaSwag | 54.16 |
| PIQA | 73.50 |
| SocialIQA | 59.77 |
| WinoGrande | 55.33 |
| BBH | 34.15 |
| AVG | 54.23 |
Puro-2B57.81%
- 开放类型
- Puro 训练结果
- 原文链接
- 技术报告 / 官方模型资料 ↗
- GPU 卡时
- 22,514
- 美元成本
- $6,891
- 人民币成本估计
- ¥46,905
- 平均性能
- 57.81%
- 估算 / 测量方法
- 按实际训练时间和使用的 GPU 数量计算 GPU 卡时。
Phase 1:6,009.46 卡时。 Phase 2:16,504.95 卡时。 合计 22,514.41 卡时,不计排队、停机等未进行训练的时间。 - 价格基准
- RTX 5090:12,000 元 / 8 卡节点月 ÷ (8 × 30 × 24) = 2.0833 元/卡时,约 $0.3061/卡时。
| Benchmark | 分数(%) |
|---|---|
| GSM8K | 59.67 |
| MATH | 30.30 |
| sanitized-MBPP | 52.92 |
| HumanEval | 31.10 |
| MMLU | 57.44 |
| MMLU-Pro | 25.81 |
| ARC-Challenge | 74.24 |
| ARC-Easy | 86.07 |
| BoolQ | 76.85 |
| CommonsenseQA | 67.81 |
| HellaSwag | 63.21 |
| PIQA | 75.52 |
| SocialIQA | 63.61 |
| WinoGrande | 60.62 |
| BBH | 42.05 |
| AVG | 57.81 |
Puro-2B (UD; $4.4K)55.54%
- 开放类型
- Puro 训练结果
- 原文链接
- 技术报告 / 官方模型资料 ↗
- GPU 卡时
- 14,262
- 美元成本
- $4,365
- 人民币成本估计
- ¥29,712
- 平均性能
- 55.54%
- 估算 / 测量方法
- 按实际训练时间和使用的 GPU 数量计算 GPU 卡时。
第一阶段使用 24 张 GPU,第二阶段使用 96 张 GPU。合计约 14,262 卡时、4,365 美元,图中标作 $4.4K。平均分为 55.54%。 - 价格基准
- RTX 5090:12,000 元 / 8 卡节点月 ÷ (8 × 30 × 24) = 2.0833 元/卡时,约 $0.3061/卡时。
| Benchmark | 分数(%) |
|---|---|
| GSM8K | 56.03 |
| MATH | 27.86 |
| sanitized-MBPP | 49.81 |
| HumanEval | 20.73 |
| MMLU | 54.82 |
| MMLU-Pro | 24.02 |
| ARC-Challenge | 66.78 |
| ARC-Easy | 84.66 |
| BoolQ | 77.34 |
| CommonsenseQA | 67.65 |
| HellaSwag | 63.62 |
| PIQA | 75.84 |
| SocialIQA | 62.90 |
| WinoGrande | 59.91 |
| BBH | 41.14 |
| AVG | 55.54 |
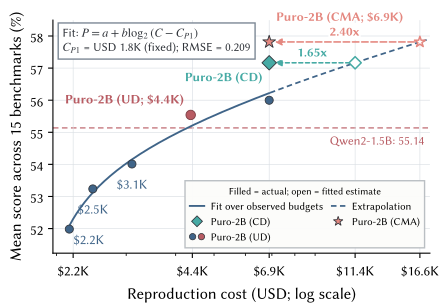
预算更少,模型能训到什么水平?我们拟合了一条成本—性能经验曲线(Puro Cost Scaling Law),用来估计不同预算下的模型表现。具体来说,我们从同一个第一阶段检查点出发,在第二阶段将数据随机打乱(Uniform Data,UD),按不同预算完成训练,再拟合平均评测得分与总成本的关系。这条曲线针对 Puro 配方,帮助研究者在正式训练前估计性能、调整方案,而不必先复现最长的训练过程。
我们从硬件选择、低精度训练、优化器改进、高质量数据利用效率和数据选择五个方面入手,降低预训练成本。
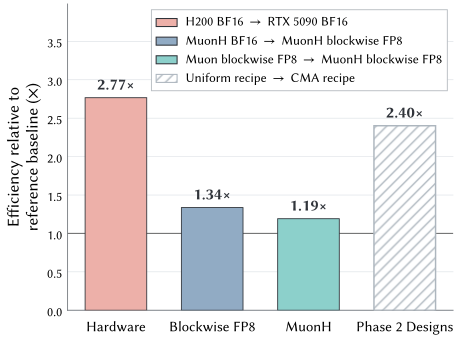
RTX 5090:单位成本,更高算力
我们先从硬件选择开始:同样的预算能买到多少算力?我们按 H200 的租赁报价,以及 RTX 5090 按五年摊销的硬件成本加电费,计算各自的单卡小时成本(RTX 5090 的核算价格与我们了解到的实际市场租赁价格接近)。在这一统计口径下,RTX 5090 每美元可提供的 BF16 峰值计算量约为 H200 的 2.77 倍。它的单卡峰值算力较低,但卡时成本降得更多,所以同样预算能买到更多计算量。除此之外,RTX 5090 这类消费级显卡,也便于普通实验室采购。
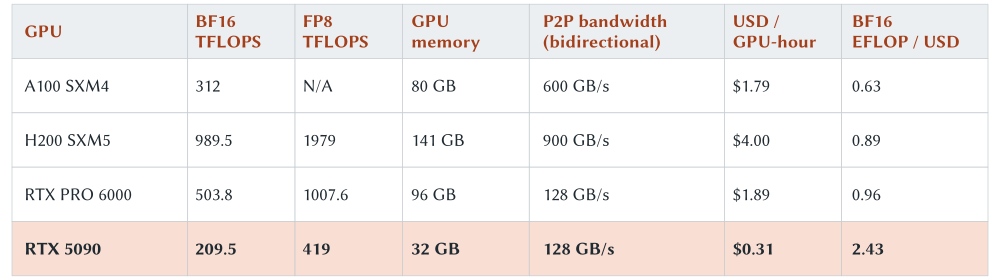
优化卡间通信。RTX 5090 只有 32 GB 显存,也没有 NVLink,不能直接照搬数据中心 GPU 的训练配置。我们通过调整驱动和系统配置,在节点内启用 PCIe P2P 通信,将 GPU 间单向带宽从 31.5 GB/s 提升到 56 GB/s,通信延迟从 14.3 µs 降低到 0.4 µs。在节点间,我们启用 GPUDirect RDMA,让 24 卡 AllReduce 总线带宽从 8.87 GB/s 提升到 19.93 GB/s。 3, 4
平衡计算与显存负载。针对十亿级参数模型和 RTX 5090 的硬件特点,我们结合数据并行与流水线并行,避免通信频繁的张量并行。随后,我们重新分配流水线各阶段的计算量,调整微批次大小,并按显存占用分配优化器状态,平衡不同节点的显存负载。这些调整使综合 MFU 超过 70%,将消费级显卡的价格优势转化为实际训练成本的降低。
2.77×效率收益与实验依据
H200 BF16 → RTX 5090 BF16
我们想比较的是:同样一笔预算,用哪款 GPU 能买到更多 BF16 计算量?这既取决于 GPU 每秒能做多少计算,也取决于这笔钱能让它运行多久。H200 的 BF16 峰值算力为 989.5 TFLOP/s,每卡时 4 美元。RTX 5090 为 209.5 TFLOP/s,每卡时约 0.3061 美元。RTX 5090 的价格由我们的硬件和电费成本折算而来:一个 8 卡节点每月约 12,000 元。
以 1 美元为例,H200 可以运行 1/4 小时,即 0.25 小时,而 RTX 5090 可以运行 1/0.3061 ≈ 3.27 小时。把各自的运行时间乘以峰值算力,再比较两者,得到 (209.5 ÷ 0.3061) ÷ (989.5 ÷ 4) ≈ 2.77。也就是说,虽然 RTX 5090 的单卡峰值算力更低,但价格降得更多,因此相同预算能购买约 2.77 倍的 BF16 峰值计算量。
有了更划算的算力,接下来我们尝试用 FP8 加快训练。
FP8:加快 RTX 5090 上的训练
RTX 5090 的 Blackwell 架构还为 FP8 训练提供了基础。我们沿用 DeepSeek-V3 的细粒度分块量化思路,将主要线性层的矩阵乘法放在 FP8 路径上,同时让数值敏感操作和训练状态保留 BF16 或 FP32 精度,形成整体 FP8 方案。 5
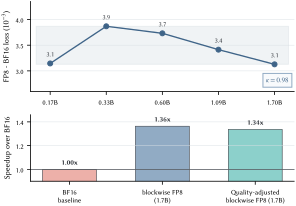
提速能否抵消精度损失?我们通过五个模型规模的对照实验(Scaling Ladder),比较 FP8 与 BF16 的净效率。FP8 的验证损失高出约 0.003–0.004,差距较小且跨规模稳定。与此同时,在 1.7B 模型上,FP8 的训练吞吐效率提升到 BF16 的 1.36 倍。要判断净收益,还需要扣除 FP8 为达到 BF16 相同损失所需的额外计算量。经过这一质量校正,据估计仍有约 1.34 倍净效率收益。
1.34×效率收益与实验依据
MuonH BF16 → MuonH 分块 FP8
FP8 跑得更快,但数值精度更低。要判断它最终节省多少训练时间,我们需要把两件事一起考虑:每秒能处理多少 token,以及达到同样验证损失需要多少训练算力。
我们先在五个模型规模上比较 BF16 与分块 FP8。相较 BF16,FP8 的验证损失值高出约 0.003–0.004。根据损失与计算量的拟合曲线,把这部分差距折算到达到同样损失所需的计算量,我们发现,FP8 还是保留约 98% 的计算效率。
再看运行速度:在 1.7B 模型上,FP8 的实测吞吐量约为 BF16 的 1.36 倍。将吞吐收益与上面的效率系数结合,得到约 1.34 倍的净收益。因此,达到相同验证损失时,预计可节省约 25.2% 的 GPU 卡时。
MuonH:从有效学习率出发设计优化器与调度
精度决定更新的计算方式,优化器和学习率(learning rate,LR)决定更新的方向和步长。我们采用 MuonH:在 Muon 的基础上归一化更新,并在每次更新后将权重投影回固定半径的球面。有效学习率(effective learning rate,ELR)衡量更新量相对于权重尺度的大小。MuonH 同时控制更新范数和权重范数,使它负责的矩阵参数的学习率在数值上等于 ELR(按投影前的更新量计算)。因此,设定这些参数的学习率调度,也就直接设定了 ELR 的变化过程。 6
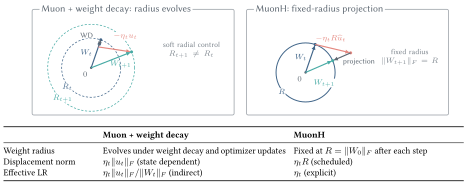
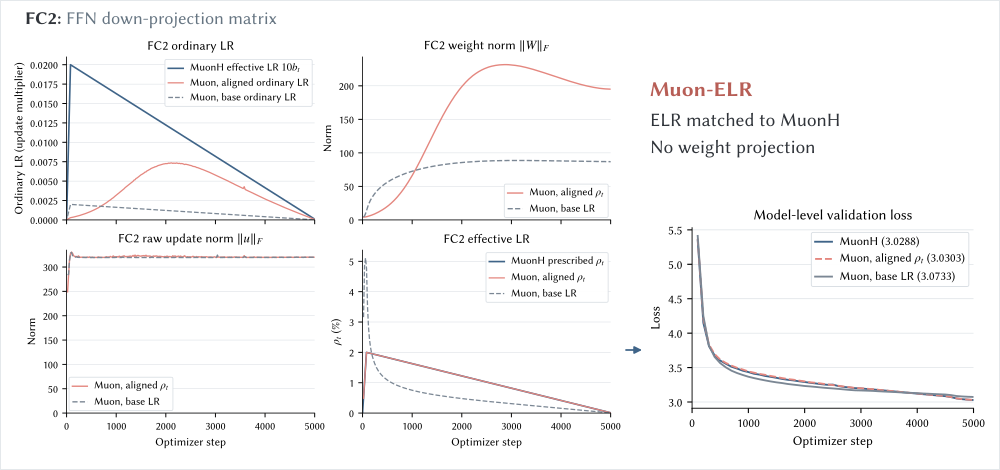
只对齐 ELR,普通 Muon 能否重现 MuonH 的损失曲线?我们在 170M 参数模型上进行了 BF16 对照实验。这个对照记作 Muon-ELR:不做固定半径的权重投影,让权重范数在训练中自然变化,只动态调整普通学习率,使其 ELR 轨迹与 MuonH 对齐。MuonH 的 ELR 就是为其矩阵参数预设的学习率,因此对齐的目标也是 MuonH 的学习率调度。对齐后,两者的损失曲线几乎重合。这说明,MuonH 在这组实验中的优势不能仅归因于范数约束,有效学习率 ELR 的变化过程是理解超球优化效果的关键。 6, 11
有效学习率:半径与更新角度
170M · BF16就绪。
数值来自同一组 BF16 对照实验,同一指标共用纵轴范围。
左右滑动查看完整对照
Muon常规 Muon
模型结构 +- Scalar LR · η
- 1.021e-3
- Weight norm · ‖W‖
- 87.89
- Update norm · ‖u‖乘学习率之前
- 319.65
- Effective LR · ρ
- 3.887e-3
MuonH固定半径
模型结构 +- Scalar LR · η
- 1.021e-2
- Weight norm · ‖W‖
- RR = ‖W₀‖
- Update norm · ‖u‖乘学习率之前
- R‖R û‖ = R
- Effective LR · ρ
- 1.021e-2
Muon-ELR对齐 ELR
模型结构 +- Scalar LR · η
- 7.020e-3
- Weight norm · ‖W‖
- 226.88
- Update norm · ‖u‖乘学习率之前
- 320.83
- Effective LR · ρ
- 1.022e-2
备注:示意图的简化与尺度
为直观比较三种配置,这里将高维参数更新简化为二维切向更新示意。在这个简化关系中,有效学习率 ρ 对应的角度为 θ = arctan ρ。绘图统一将角度放大 20 倍,以便看清 MuonH 与 Muon-ELR 的角度是否接近。半径采用对数尺度,并将每组第 20 步的权重范数归一为 1,以虚线圆作参照,因此圆的扩张反映各组相对起点的范数变化。
这里的 ELR 按投影前的更新量计算。MuonH 的等式针对矩阵参数;其余参数组采用 AdamW 和基础学习率。
Muon · 模型结构
虚线框标出矩阵参数组,FC2 为这里跟踪的参数;其余参数由 AdamW 更新。
MuonH · 模型结构
虚线框标出矩阵参数组,FC2 为这里跟踪的参数;其余参数由 AdamW 更新。
Muon-ELR · 模型结构
虚线框标出矩阵参数组,FC2 为这里跟踪的参数;其余参数由 AdamW 更新。
进一步比较发现,当 weight decay 不足以约束权重范数时,普通 Muon 的 ELR 在训练前期下降更快,损失也更早降低。MuonH 的 ELR 衰减更平缓,后期表现更好。因此,我们不再只比较“用哪个优化器”,也开始研究“如何设计有效学习率调度(ELR schedule)”。 7
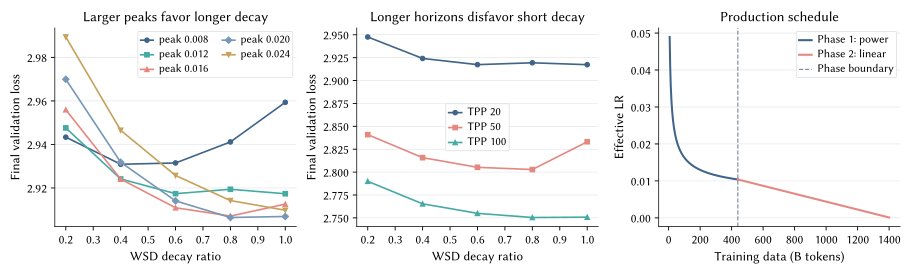
衰减阶段应该多长?我们使用预热—稳定—衰减(Warmup-Stable-Decay,WSD)学习率调度,比较不同峰值学习率、训练数据量和衰减阶段占比的影响。结果显示,较高的峰值学习率和更长的训练周期,通常更需要较长的衰减过程。这些观察支持在第二阶段采用长线性衰减,为最终的损失收敛留出空间。第一阶段采用 power schedule,则是为了在不预设终点的情况下支持持续训练。 8
左图:峰值 LR 与衰减占比
固定 TPP = 20(11.32B tokens)
中图:训练长度与衰减占比
固定峰值有效 LR = 0.012
右图:两阶段学习率
Phase 1 幂律衰减,Phase 2 线性衰减
查看实验设置与结果
示例
| 峰值有效 LR | TPP | WSD 衰减比例 | 最终 val loss |
|---|---|---|---|
| 0.008 | 20 | 20% | 2.943 |
| 0.008 | 20 | 40% | 2.931 |
| 0.008 | 20 | 60% | 2.931 |
| 0.008 | 20 | 80% | 2.941 |
| 0.008 | 20 | 100% | 2.959 |
| 0.012 | 20 | 20% | 2.948 |
| 0.012 | 20 | 40% | 2.924 |
| 0.012 | 20 | 60% | 2.917 |
| 0.012 | 20 | 80% | 2.919 |
| 0.012 | 20 | 100% | 2.917 |
| 0.012 | 50 | 20% | 2.841 |
| 0.012 | 50 | 40% | 2.816 |
| 0.012 | 50 | 60% | 2.805 |
| 0.012 | 50 | 80% | 2.803 |
| 0.012 | 50 | 100% | 2.833 |
| 0.012 | 100 | 20% | 2.790 |
| 0.012 | 100 | 40% | 2.765 |
| 0.012 | 100 | 60% | 2.755 |
| 0.012 | 100 | 80% | 2.750 |
| 0.012 | 100 | 100% | 2.751 |
| 0.016 | 20 | 20% | 2.956 |
| 0.016 | 20 | 40% | 2.924 |
| 0.016 | 20 | 60% | 2.911 |
| 0.016 | 20 | 80% | 2.907 |
| 0.016 | 20 | 100% | 2.913 |
| 0.020 | 20 | 20% | 2.970 |
| 0.020 | 20 | 40% | 2.932 |
| 0.020 | 20 | 60% | 2.914 |
| 0.020 | 20 | 80% | 2.906 |
| 0.020 | 20 | 100% | 2.907 |
| 0.024 | 20 | 20% | 2.989 |
| 0.024 | 20 | 40% | 2.946 |
| 0.024 | 20 | 60% | 2.926 |
| 0.024 | 20 | 80% | 2.914 |
| 0.024 | 20 | 100% | 2.910 |
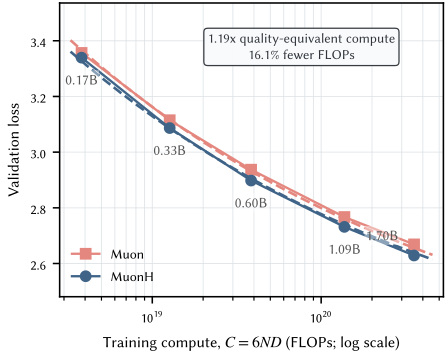
再比较达到相同损失的计算成本。前面的 ELR 对齐实验检验的是,普通 Muon 能否重现 MuonH 的损失曲线。这里比较的是两套训练配方达到相同验证损失各需多少计算量。我们在 0.17B–1.7B 的五组模型规模上进行扩展阶梯(Scaling Ladder)实验,两组都使用分块 FP8。这里的普通 Muon 基线采用按模型规模设定的学习率,并作线性衰减,不是前面逐步调整普通学习率、主动匹配 MuonH ELR 的 Muon-ELR 对照。对这五组实验拟合损失—计算量曲线后,MuonH 方案的训练效率约为调参后 Muon 基线的 1.19 倍。
同等损失,需要多少计算量?
两组均使用分块 FP8。
验证损失: 2.991
训练计算量 C = 6ND(FLOPs,对数轴)
散点:实验;虚线:拟合
- 调参后 Muon
- 2.63e+19 FLOPs
- MuonH
- 2.20e+19 FLOPs
- CE = Muon / MuonH
- 1.19×
已减少动态效果,可逐步前进或拖动滑块。
已暂停
CE 怎么算?
Lg(C) = E + Ag (C / C₀)−α
CE = CMuon / CMuonH = (AMuon / AMuonH)1/α
两组共享损失下限 E 和指数 α,使得拟合的 CE 不随 compute 改变。
1.19×效率收益与实验依据
调参后 Muon → MuonH(均为分块 FP8)
这里要回答的是:达到同样的验证损失,MuonH 能比 Muon 少用多少计算量?我们在相同的一组模型规模上训练两种优化器,都使用分块 FP8,并对 Muon 基线进行调参。随后,根据实验点拟合两条损失—计算量曲线。
在同一个验证损失处,分别读取两条曲线对应的 FLOPs。Muon 所需计算量约为 MuonH 的 1.19 倍。换一种说法,如果 Muon 需要 100 份计算量,MuonH 大约需要 84 份,节省约 16.1%。
CMA:让训练后期的高质量数据得到充分利用
除了优化器,数据顺序也会影响训练效率。高质量样本在训练集中占比不高,却很重要,将它们放在训练后段有助于提高利用效率。许多开源数据集提供样本质量分数。我们据此在各数据源内部把高质量样本排到后段,再按训练进度对齐、混合不同来源的数据块。随着训练推进,模型会接触到质量更高的样本,同时,局部训练区间内的数据源配比保持近似稳定,避免质量变化伴随领域比例的突变。
课程数据构造示意
- 源内质量:浅 → 深
- A
- B
- C: 无质量评分
已减少动态效果,可逐步前进或拖动滑块。
原始样本
源 A
源 B
源 C
源内排序
源 A
源 B
源 C
相对 token 进度
按进度混合
混合 10–⅓
混合 2⅓–⅔
混合 3⅔–1
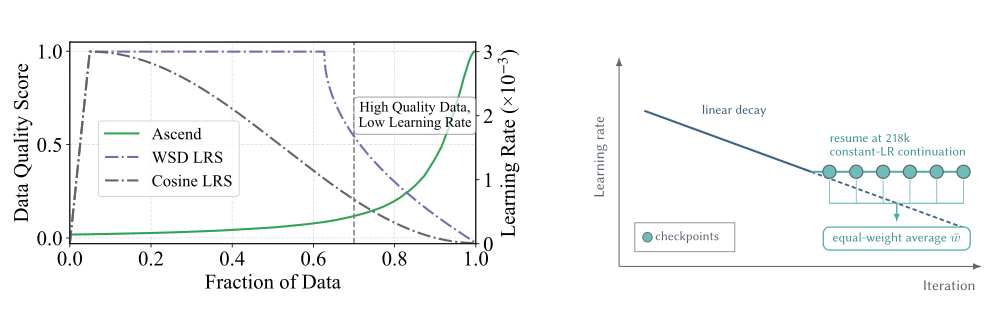
高质量数据放在训练后段,学习率也需要相应调整。我们此前的研究发现:当训练后期学习率过低时,最后出现的优质数据难以推动参数更新。因此,我们采用课程模型平均(Curriculum Model Averaging,CMA)。我们先在第二阶段按线性衰减方案训练,再从这条轨迹上第 218,000 步保存的检查点恢复训练。续训时,学习率固定为该步的数值,不再衰减,让模型继续学习后续的高质量数据。最后,我们对续训末端六个检查点的对应模型参数求算术平均,用平均后的参数构成最终模型,减小单个检查点波动对结果的影响。 9
预训练模型合并的近期进展还包括 Extra-Merge,它沿合并后的检查点轨迹进行外推,无需额外的梯度更新。 12 本文的 CMA 采用等权检查点平均,不使用外推。
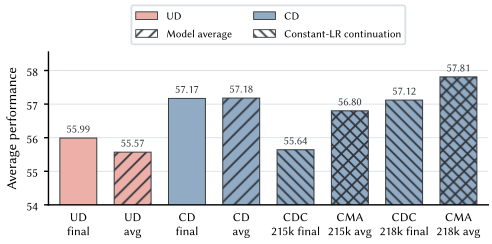
数据顺序有多大影响?在相同的数据与学习率衰减设置下,课程排布优于随机排布:CD decay final 的平均分为 57.17,高于 UD decay final 的 55.99。对两条衰减轨迹分别做模型平均后,CD decay avg 为 57.18,也高于 UD decay avg 的 55.57。两组比较分别提高 1.18 和 1.61 个百分点,说明调整数据顺序本身就能带来收益。 9
衰减轨迹上的平均,收益有限。沿学习率衰减轨迹直接做模型平均,UD 的平均分从 55.99 降至 55.57,CD 则从 57.17 变为 57.18。也就是说,保留学习率衰减、只增加末端参数平均,并没有带来明显收益。
恒定学习率续训后,平均更有效。比较 CDC 215k final 与 CMA 215k avg,末端六个检查点的参数平均将分数从 55.64 提高到 56.80。在从第 218,000 步恢复后续训的实验中,参数平均将分数从 57.12 提高到 57.81,分别提升 1.16 和 0.69 个百分点。这两组实验表明,当模型以恒定学习率继续学习后期高质量数据时,模型平均更能发挥作用。最终,我们采用课程数据排布,从第 218,000 步的检查点恢复,以恒定学习率续训,再对续训末端六个检查点的参数求平均,得到 CMA 模型。
左右滑动查看完整图表
平均分(%)
UD decay final55.99UD decay avg55.57CD decay final57.17CD decay avg57.18CDC 215k final55.64CMA 215k avg56.80CDC 218k final57.12CMA 218k avg57.81UD:随机数据顺序+学习率衰减。 CD:课程顺序+学习率衰减。 CDC:CD 后接恒定学习率续训。 CMA:平均续训末端的检查点参数。 215k/218k 指从第 215,000/218,000 步恢复,final/avg 分别表示末个检查点/检查点参数平均。
各组从同一个第一阶段 checkpoint 出发,使用同一份第二阶段数据。图中 step 为全局优化器步数。
图 13 · 实验训练配置
UD decay final55.99%
训练过程示意
UD · 随机顺序
后期学习率:线性衰减
使用最终检查点
- 数据排布
- UD:将第二阶段数据全局随机打乱。
- 学习率与续训
- 第二阶段采用线性学习率衰减,训练至结束。
- 使用的 checkpoint
- 该实验训练结束时的最后一个 checkpoint。
- 模型平均
- 直接使用最终 checkpoint 的模型参数。
UD decay avg55.57%
训练过程示意
UD · 随机顺序
学习率衰减末端的检查点
- 数据排布
- UD:将第二阶段数据全局随机打乱。
- 学习率与续训
- 第二阶段采用线性学习率衰减,训练至结束。
- 使用的 checkpoint
- 衰减末端的 checkpoint;具体步数未公布。
- 模型平均
- 等权平均模型参数(SMA);不平均优化器状态。
CD decay final57.17%
训练过程示意
CD · 各源内部由低质量到高质量
后期学习率:线性衰减
使用最终检查点
- 数据排布
- CD:各源内部按质量从低到高排列,再按相同相对进度混合;无评分源保持固定随机顺序。
- 学习率与续训
- 第二阶段采用线性学习率衰减,训练至结束。
- 使用的 checkpoint
- 该实验训练结束时的最后一个 checkpoint。
- 模型平均
- 直接使用最终 checkpoint 的模型参数。
CD decay avg57.18%
训练过程示意
CD · 各源内部由低质量到高质量
学习率衰减末端的检查点
- 数据排布
- CD:各源内部按质量从低到高排列,再按相同相对进度混合;无评分源保持固定随机顺序。
- 学习率与续训
- 第二阶段采用线性学习率衰减,训练至结束。
- 使用的 checkpoint
- 衰减末端的 checkpoint;具体步数未公布。
- 模型平均
- 等权平均模型参数(SMA);不平均优化器状态。
CDC 215k final55.64%
训练过程示意
CD · 各源内部由低质量到高质量
第 215k 步恢复后保持 LR
使用最终检查点
- 数据排布
- CD:各源内部按质量从低到高排列,再按相同相对进度混合;无评分源保持固定随机顺序。
- 学习率与续训
- 从线性衰减的第 215,000 步恢复,读取后续课程数据,学习率保持在该步的值。
- 使用的 checkpoint
- 该实验训练结束时的最后一个 checkpoint。
- 模型平均
- 直接使用最终 checkpoint 的模型参数。
CMA 215k avg56.80%
训练过程示意
CD · 各源内部由低质量到高质量
恒定学习率续训末端的检查点
- 数据排布
- CD:各源内部按质量从低到高排列,再按相同相对进度混合;无评分源保持固定随机顺序。
- 学习率与续训
- 从线性衰减的第 215,000 步恢复,读取后续课程数据,学习率保持在该步的值。
- 使用的 checkpoint
- 续训末端的 6 个 checkpoint;具体步数未公布。
- 模型平均
- 等权平均模型参数(SMA);不平均优化器状态。
CDC 218k final57.12%
训练过程示意
CD · 各源内部由低质量到高质量
第 218k 步恢复后保持 LR
使用最终检查点
- 数据排布
- CD:各源内部按质量从低到高排列,再按相同相对进度混合;无评分源保持固定随机顺序。
- 学习率与续训
- 从线性衰减的第 218,000 步恢复,读取后续课程数据,学习率保持在该步的值。 基础 LR 4.08e-5,矩阵参数有效 LR 4.08e-4(10 倍)。
- 使用的 checkpoint
- 222,569 该实验训练结束时的最后一个 checkpoint。
- 模型平均
- 直接使用最终 checkpoint 的模型参数。
CMA 218k avg57.81%
训练过程示意
CD · 各源内部由低质量到高质量
恒定学习率续训末端的检查点
- 数据排布
- CD:各源内部按质量从低到高排列,再按相同相对进度混合;无评分源保持固定随机顺序。
- 学习率与续训
- 从线性衰减的第 218,000 步恢复,读取后续课程数据,学习率保持在该步的值。 基础 LR 4.08e-5,矩阵参数有效 LR 4.08e-4(10 倍)。
- 使用的 checkpoint
- 222,100 · 222,200 · 222,300 · 222,400 · 222,500 · 222,569 末端 6 个 checkpoint,覆盖 469 步(约 2.95B tokens)。
- 模型平均
- 等权平均模型参数(SMA);不平均优化器状态。
根据 Puro Cost Scaling Law 的拟合结果,相比于随机数据排布(Uniform Data,UD),课程数据配合学习率衰减的成本效率约为 1.65 倍,完整 CMA 方案则达到约 2.40 倍。
2.40×效率收益与实验依据
随机数据排布(UD)→ 完整 CMA 配方
完整 CMA 模型在 15 项基准上的平均分为 57.81,预训练计算成本约为 6,900 美元。若改用随机数据排布(UD),达到这个分数需要多少成本?
我们从同一个第一阶段 checkpoint 出发,以不同预算完成 UD 的第二阶段训练,并用这些结果拟合 Puro Cost Scaling Law。沿拟合曲线外推至平均分 57.81,UD 对应的成本约为 16,600 美元。因此,在相同分数下,两者的成本比约为 16,600 ÷ 6,900 ≈ 2.40,CMA 所需成本约为 UD 估计成本的 42%。
这组 CMA 实验先按课程顺序配合线性学习率衰减训练,再恢复第 218,000 步的 checkpoint,以该步学习率恒定续训,最后平均续训末端六个 checkpoint 的参数。图 13 对比了随机排布、课程排布、恒定学习率续训和参数平均的不同组合。点击柱子,可以查看各组的续训起点与平均范围。
数据评测:通过小规模实验评估与对比数据价值
数据顺序解决后,还要决定选哪些数据。
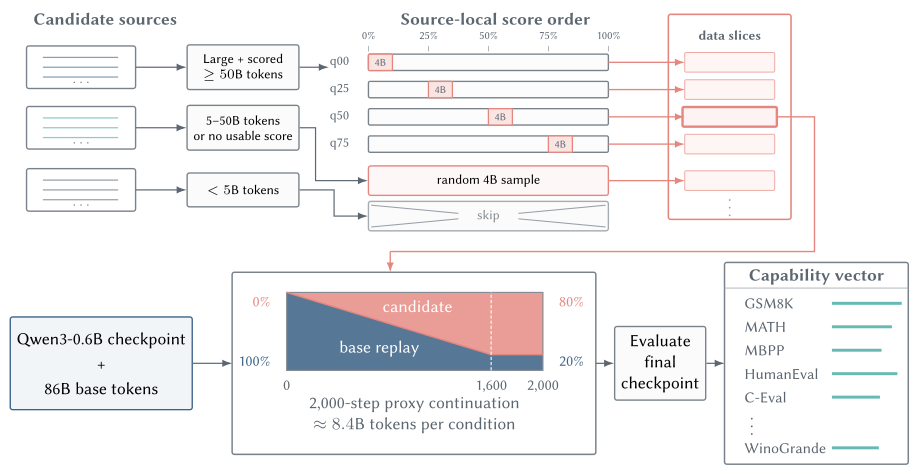
我们先从各个候选数据源中抽取一部分数据。对于大规模且有质量评分的数据集,分别从不同分数区间抽样。对于其他符合条件的数据源,则随机抽样。随后,针对每份抽样数据,我们从同一个模型检查点出发,在相同配置下继续训练,再用相同的评测比较数学、代码、中文和通用任务的分数。 10
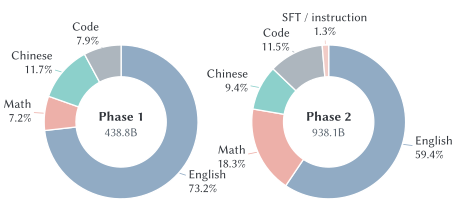
这些代理实验既能比较不同数据源,也能揭示同一来源内部的质量差异。在这些实验中,代码得分较高的数据源,往往在通用评测上得分较低。数学得分与通用得分之间的取舍则较弱。因此,我们在第二阶段给数学数据分配略高于代码数据的比例,再结合领域覆盖和质量筛选确定最终配比。小规模实验帮助我们判断保留哪些数据源和分数区间,以及各自分配多少比例。相关数据集评测结果已在报告中公开。
从节省算力,到研究完整的训练过程
在这套方案中,硬件降低每单位计算的价格,FP8 提高训练吞吐量,MuonH 减少达到相同验证损失所需的计算量,CMA 提高训练数据的利用效率,代理评测帮助比较并选择训练数据。这些改进共同组成了我们的低成本训练流程。
控制预训练,再比较后训练结果。如果只有开源权重,研究者很难控制模型此前的预训练过程。使用 Puro-2B,研究者可以在较低预算下修改预训练方案,再采用相同的微调和评测流程,比较这些修改对最终模型的影响。
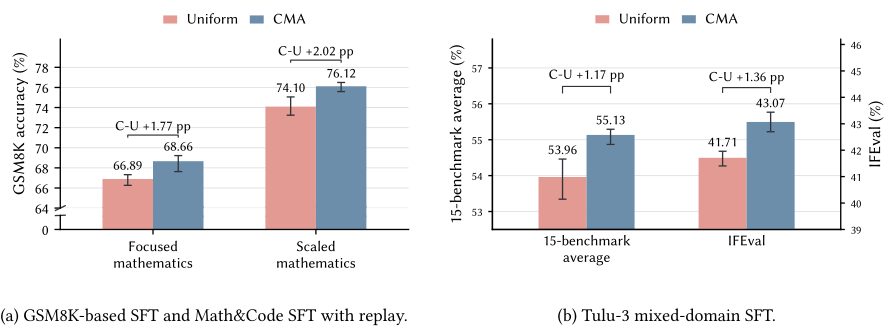
CMA 的收益能否延续到后训练?我们对 CMA 与 Uniform 两个预训练权重采用相同的微调流程。在两组数学能力的微调实验中,基于 CMA 初始化微调的 GSM8K 准确率分别高出 1.77 和 2.02 个百分点。在 Tulu-3 混合领域微调中,15 项基准平均分提高 1.17 个百分点,IFEval 提高 1.36 个百分点。这三组对照均呈现总体提升,说明 CMA 的收益在这些微调设置下能够延续到后训练。 9
全流程开源
我们公开了最终模型、中间检查点,以及训练数据和训练框架。模型权重与项目代码采用 Apache 2.0 许可,而源数据集仍需遵循各自上游条款。开源材料包括:
-
模型与中间检查点:Puro-2B 开源合集
-
训练数据与配比:Puro-2B Dataset
-
训练代码:Puro-Megatron
-
数据处理代码:Kaiyuan-Spark 10
其他团队可以用这些材料复现 Puro-2B,也可以在此基础上调整优化器、学习率或数据配方,用相同的评测比较不同方案的训练成本和模型表现。
注:本项目的成本核算针对正式预训练的 GPU 算力成本,不包含数据处理、消融实验、后训练和研发人力等项目总开支。
致谢
感谢李怡康、周文杰、陈诺审阅本文并提出改进意见。感谢衍复投资提供算力支持。
引用
如果这项工作对你有帮助,欢迎引用我们的论文:
@misc{luo2026puro2bpoorlabsqwen215b,
  title={Puro-2B: Poor Lab's Qwen2-1.5B Trained on RTX 5090 within $5090},
  author={Kairong Luo and Jiarui Cui and Yaorui Yin and Shengqi Chen and Yiming Yang and Linxiang Gao and Yanmohan Wang and Chengxia Li and Mingzhe Zhang and Kaifeng Lyu and Wenguang Chen},
  year={2026},
  eprint={2608.27370},
  archivePrefix={arXiv},
  primaryClass={cs.CL},
  url={https://arxiv.org/abs/2608.27370},
}参考文献
- OLMoE: Open Mixture-of-Experts Language Models
Niklas Muennighoff, et al. ICLR 2025
- SmolLM3: smol, multilingual, long-context reasoner
Hugging Face SmolLM team Hugging Face · 2025
- 在 RTX 5090 上启用 PCIe P2P 通信支持
Shengqi Chen Harry Chen’s Blog · 2026-03-22
- 在 RTX 5090 上启用 GPUDirect RDMA 通信支持
Shengqi Chen Harry Chen’s Blog · 2026-05-20
- DeepSeek-V3 Technical Report
DeepSeek-AI arXiv:2412.19437 · 2024
- Fantastic Pretraining Optimizers and Where to Find Them II: Hyperball Optimization
Kaiyue Wen, Xingyu Dang, Kaifeng Lyu, Tengyu Ma, Percy Liang arXiv:2606.16899 · 2026
- A Multi-Power Law for Loss Curve Prediction Across Learning Rate Schedules
Kairong Luo, Haodong Wen, Shengding Hu, Zhenbo Sun, Zhiyuan Liu, Maosong Sun, Kaifeng Lyu, Wenguang Chen ICLR 2025 arXiv ↗
- Power Scheduler: A Batch Size and Token Number Agnostic Learning Rate Scheduler
Yikang Shen, Matthew Stallone, Mayank Mishra, Gaoyuan Zhang, Shawn Tan, Aditya Prasad, Adriana Meza Soria, David D. Cox, Rameswar Panda arXiv:2408.13359 · 2024
- How Learning Rate Decay Wastes Your Best Data in Curriculum-Based LLM Pretraining
Kairong Luo, Zhenbo Sun, Haodong Wen, Xinyu Shi, Jiarui Cui, Chenyi Dang, Kaifeng Lyu, Wenguang Chen ICLR 2026 arXiv ↗
- PCMind-2.1-Kaiyuan-2B Technical Report
Kairong Luo, Zhenbo Sun, Xinyu Shi, Shengqi Chen, Bowen Yu, Yunyi Chen, Chenyi Dang, Hengtao Tao, Hui Wang, Fangming Liu, Kaifeng Lyu, Wenguang Chen arXiv:2512.07612 · 2025
- From LR to ELR: A Better Heuristic for Pretraining Dynamics
Zhanpeng Zhou, Wenjie Zhou, Yufei Gu, Juqiu Wang, Guanwei Zhang, Ruobing Xie, Xianbiao Qi, Yushi Bai, Kaifeng Lyu, Shunyu Yao Tencent Hunyuan · 2026
- Extra-Merge: Tracing the Rank-1 Subspace of Model Merging in Language Model Pre-Training
Wenjie Zhou, Bohan Wang, Hongtao Zhang, Chenxi Jia, Wei Chen, Xueqi Cheng arXiv:2605.26484 · 2026